近日,罗亚威教授走进我校翔安高中校区,在图书信息中心四楼阶梯教室,为高一、高二年级同学作题为“人工智能:从深度学习到未来智能体”的讲座。
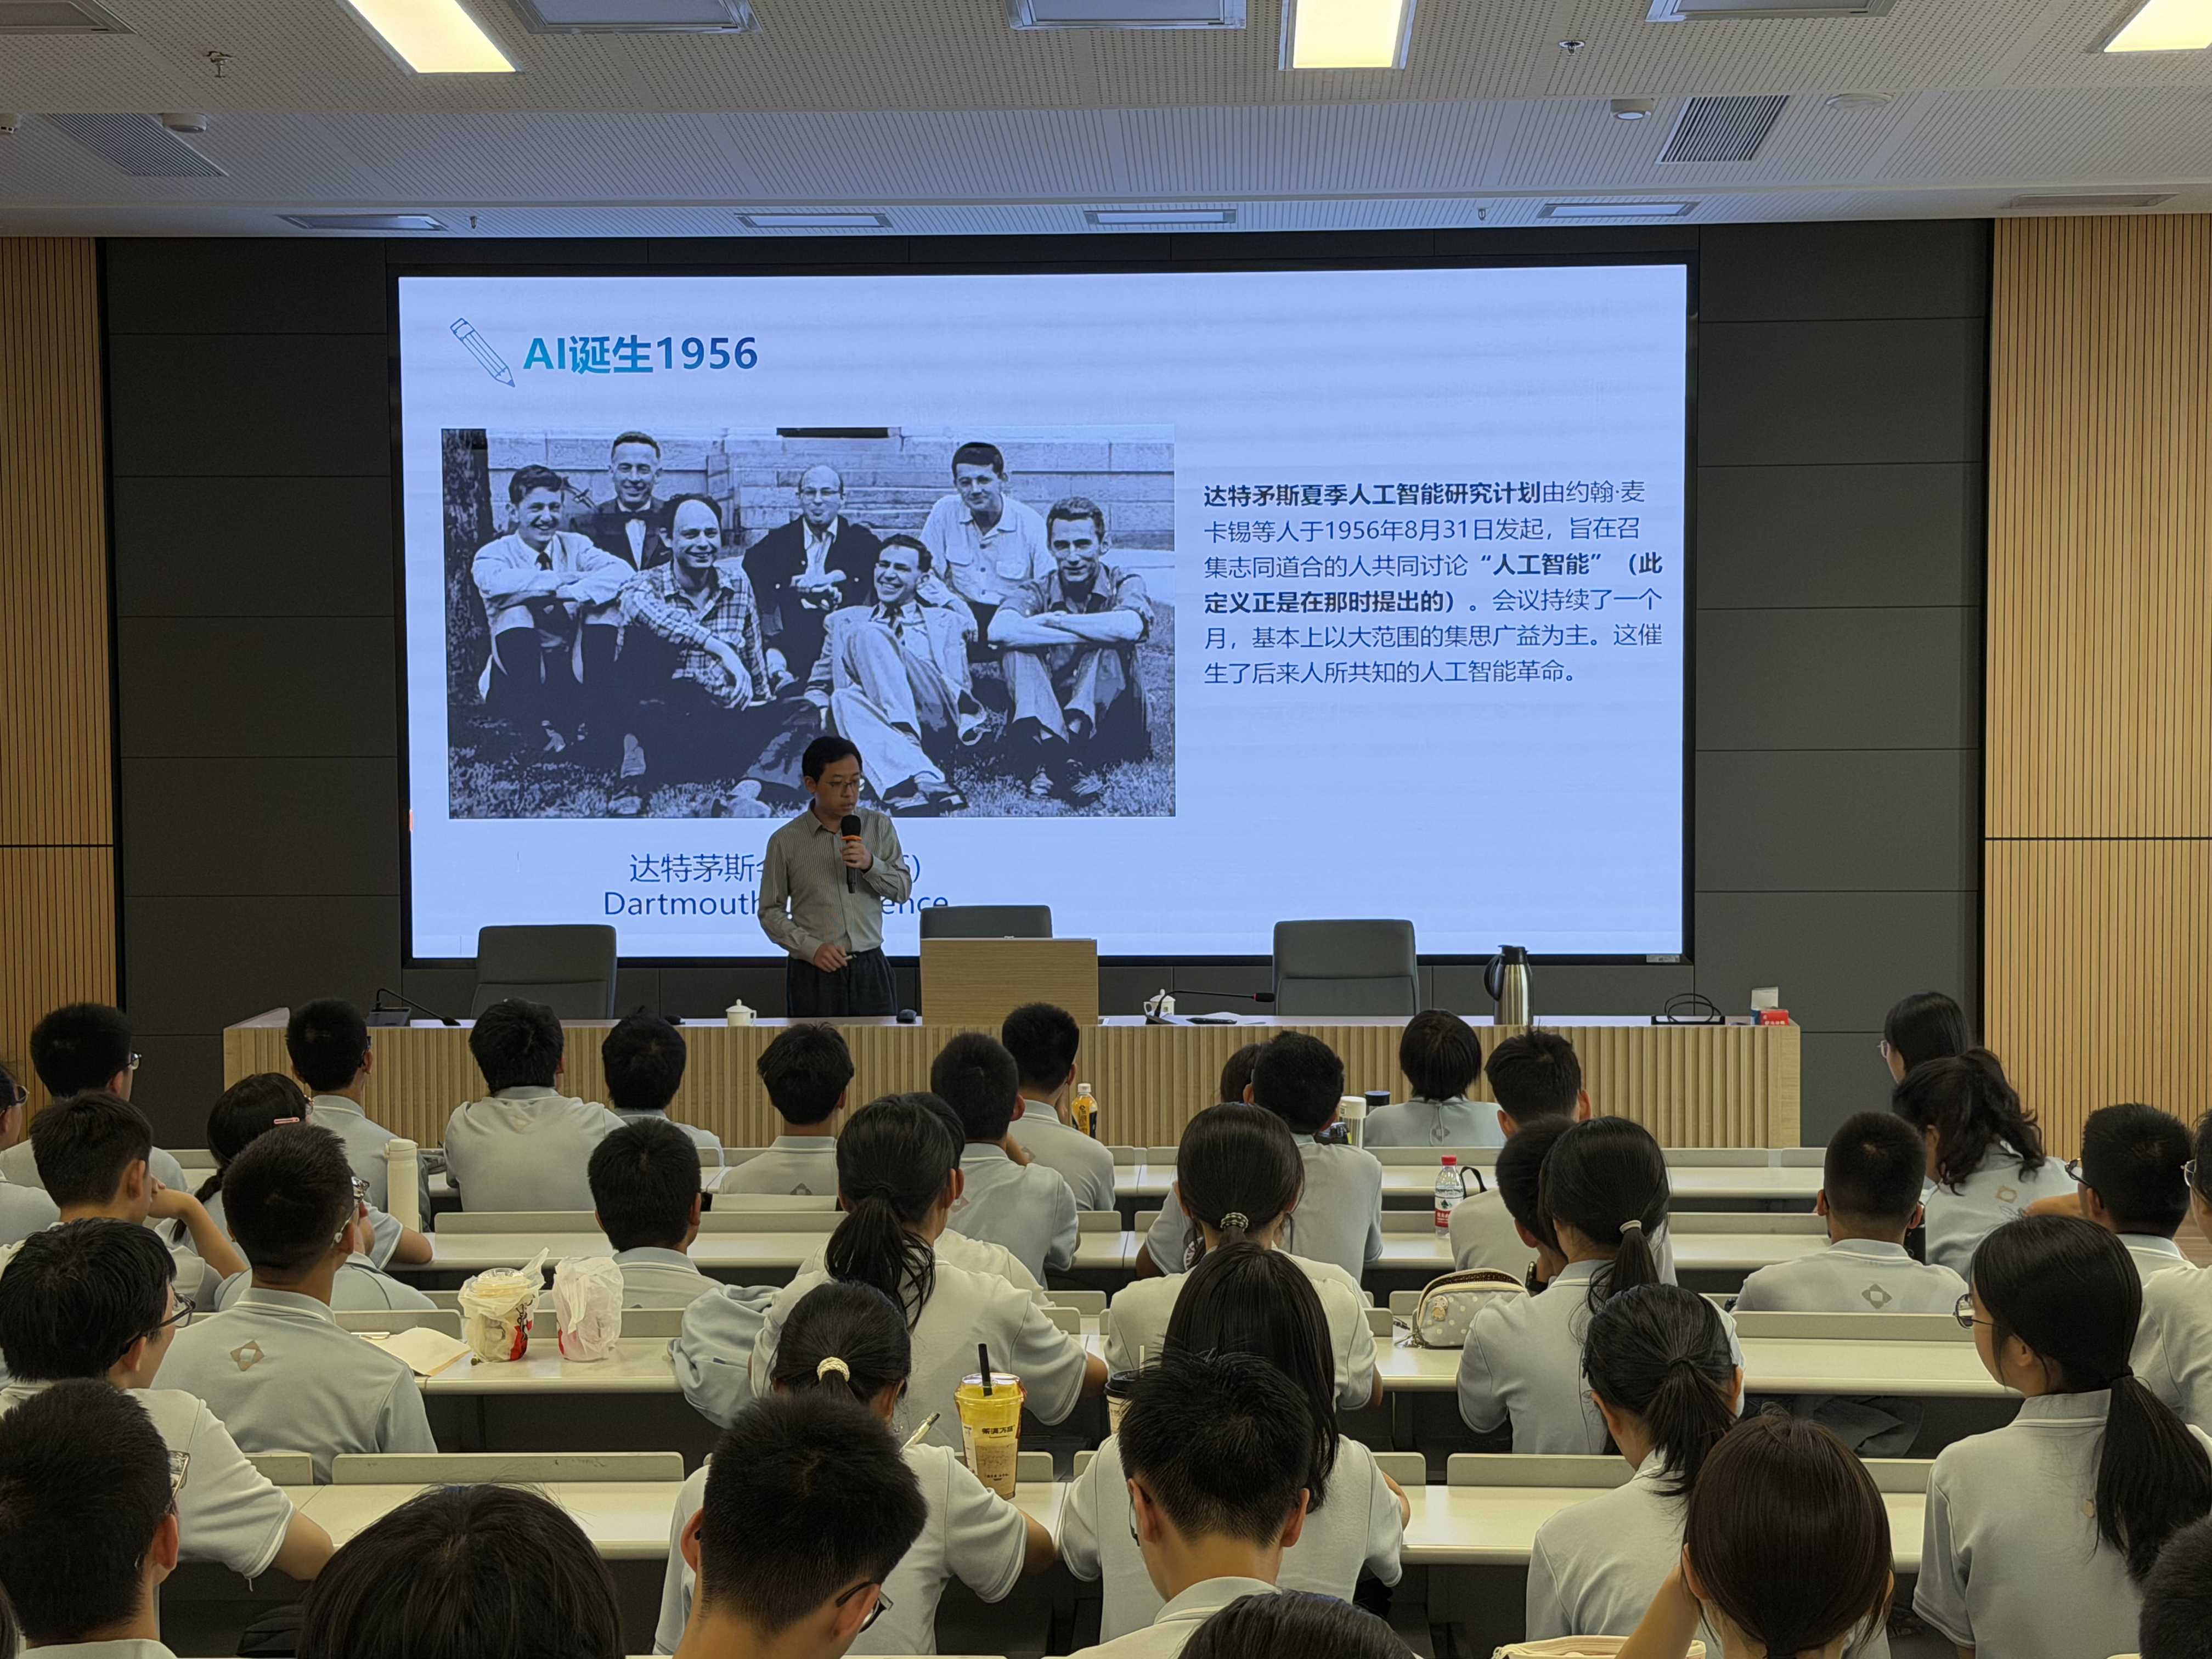
讲座从“图灵之问”讲起。罗亚威教授以一张“AI简史”时间轴回顾AI数十年的起伏,并借图灵奖、吴文俊人工智能科学技术奖两项大奖,为这场技术浪潮定调。
罗亚威教授把深度学习拆解为三个要素:架构即神经网络,如同对人类大脑的模拟;数据是“燃料”,好比书本为人提供知识;训练方法则像“教师”,教会模型如何解析数据。
他把神经元被激活的机制类比为模型中“加权求和—激活函数判断”的过程。三要素协同决定模型上限。
以图像识别为例,浅层卷积核如同“滑动窗口”,逐一感知局部像素,再逐层推理完成识别;但受限于“感受野”,难免管中窥豹,浅层判断有误,深层往往难以纠正。现场“局部看纹理猜动物”的互动,演示的正是这一局限。
Transformer则以全局关联推理破局:信息统一进入编码器,注意力机制能捕捉长句中的指代关系,也能在图像中聚焦关键区域。
“没有标签的数据,还能不能训练神经网络?”罗亚威教授由此引出自监督学习:拼图法让模型在重组图像中隐式学习空间表征,掩码还原法让模型恢复被遮挡的区域,共同的逻辑是“以数据自身为师”。先“预习”世界规律,后续接入标签时,拟合速度便远胜从零训练。
生成式AI通过学习数据分布创造新样本,“无中生有”地生成文本与图像。结合课题组的三维视觉世界模型,他展示了骨骼、图片、视频等多种驱动方式——以骨骼驱动生成游动的乌贼、活动的鸭子。原理上,可见部分由判别式AI恢复,被遮挡部分由生成式AI补全,正是“看得到的靠算,看不到的靠猜”。
此前的模型只停留在屏幕推理,无法与物理世界交互,这正是具身智能要解决的问题。它借助物理传感器感知温度、摩擦力等现实规律。视频里,机器人从单脚到双脚,从翻跟头到以灵巧手抓取零件与人类协作;其决策靠大语言模型融合多模态信息,动作由“小脑”完成。
他也坦言,机器人马拉松中的摔倒与撞人事故,暴露出落地的现实瓶颈,课题组因此选择“虚拟环境模拟+真实数据微调”的虚实结合路线。
展望未来,生成式AI将与具身智能深度融合,让机器人不仅执行指令,还能感知并回应人的情绪,从“执行工具”进化为“智能伙伴”。罗亚威教授寄语同学们,积极投身AI的新方向。